“模型权重只有十几 GB,为什么训练要这么多显存?”原因是训练会保存更多东西。理解 DeepSpeed,可以先做一次显存记账,再看哪些状态在多张卡上重复保存。
训练的一步在做什么
flowchart TB
    A[样本与标签] --> B[前向计算预测和损失]
    B --> C[反向传播计算梯度]
    C --> D[优化器更新模型参数]
    D --> E[下一步训练]
参数决定当前模型怎样计算;梯度描述损失对参数的变化;优化器依据梯度和自己的状态计算更新。DeepSpeed 的训练引擎将这些工作组织在 forward、backward 与 step 接口中。DeepSpeed Getting Started
这里的模型状态,与推理阶段不断增长的 KV Cache,是不同的记账对象。
一个便于手算的混合精度账本
设参数量为 $P$。考虑一种典型的 FP16 参数和梯度、FP32 主副本及 Adam 一二阶状态的全参数训练布局:
| 保存的内容 | 每个参数的字节数 | 用途 |
|---|---|---|
| FP16 参数 | 2 | 参与模型计算 |
| FP16 梯度 | 2 | 记录参数更新方向 |
| FP32 参数主副本 | 4 | 在更高精度下维护更新 |
| Adam 一阶状态 | 4 | 累积梯度的一阶统计 |
| Adam 二阶状态 | 4 | 累积梯度的二阶统计 |
| 合计 | 16 | 只统计上述模型状态 |
这组布局是 ZeRO 原论文分析的重要入门模型;Adam 的一、二阶统计来自其优化方法。ZeRO 论文、Adam 论文
例如 $P=7\times10^9$ 时,状态合计为 $16P=112$ GB。这不是全部训练显存:激活、通信缓冲、临时聚合和运行时还没算进去。不同精度、优化器实现、LoRA 或量化训练应重建账本,不能统一套用 16 字节。
普通数据并行为什么有冗余
假设四位同学分头做不同的题,但每人桌上都放着一整套相同的教材、答案草稿和统计表。在普通数据并行中,各卡处理不同样本,通常保留完整模型状态,并通过通信协调梯度。
ZeRO 的核心是减少数据并行进程之间重复保存的状态,把保存与更新责任分开。ZeRO 论文
ZeRO 三个阶段分别切什么
| 方案 | 参数 | 梯度 | 优化器状态 |
|---|---|---|---|
| 普通数据并行 | 每卡完整保存 | 每卡完整保存 | 每卡完整保存 |
| ZeRO 1 | 每卡完整保存 | 每卡完整保存 | 分片保存 |
| ZeRO 2 | 每卡完整保存 | 分片保存 | 分片保存 |
| ZeRO 3 | 分片保存 | 分片保存 | 分片保存 |
“分片”针对对应数据并行组。ZeRO 3 计算某层时仍需要收集所需参数,不能理解成每张卡从头到尾只计算四分之一模型。DeepSpeed ZeRO 文档
flowchart TB
    A[完整的优化器状态] --> B[切成四份]
    B --> C[GPU 0 保存第 1 份]
    B --> D[GPU 1 保存第 2 份]
    B --> E[GPU 2 保存第 3 份]
    B --> F[GPU 3 保存第 4 份]
上图只画 ZeRO 1 的优化器状态分工。ZeRO 2、3 将分工进一步扩展到梯度和参数,并增加相应的通信安排。
手算四卡时的状态显存
沿用前述精度假设,设数据并行组大小为 $N$,忽略分片不均和临时开销,每卡理论常驻状态可以近似为:
$$ M_{DP}=16P $$
$$ M_{Z1}=4P+\frac{12P}{N} $$
$$ M_{Z2}=2P+\frac{14P}{N} $$
$$ M_{Z3}=\frac{16P}{N} $$
这些公式由上面的分片表逐项相加得到。取 7B 参数、四卡数据并行:
| 方案 | 每卡理论状态 GB | 换算为 GiB |
|---|---|---|
| 普通数据并行 | 112 | 104.31 |
| ZeRO 1 | 49 | 45.63 |
| ZeRO 2 | 38.5 | 35.86 |
| ZeRO 3 | 28 | 26.08 |
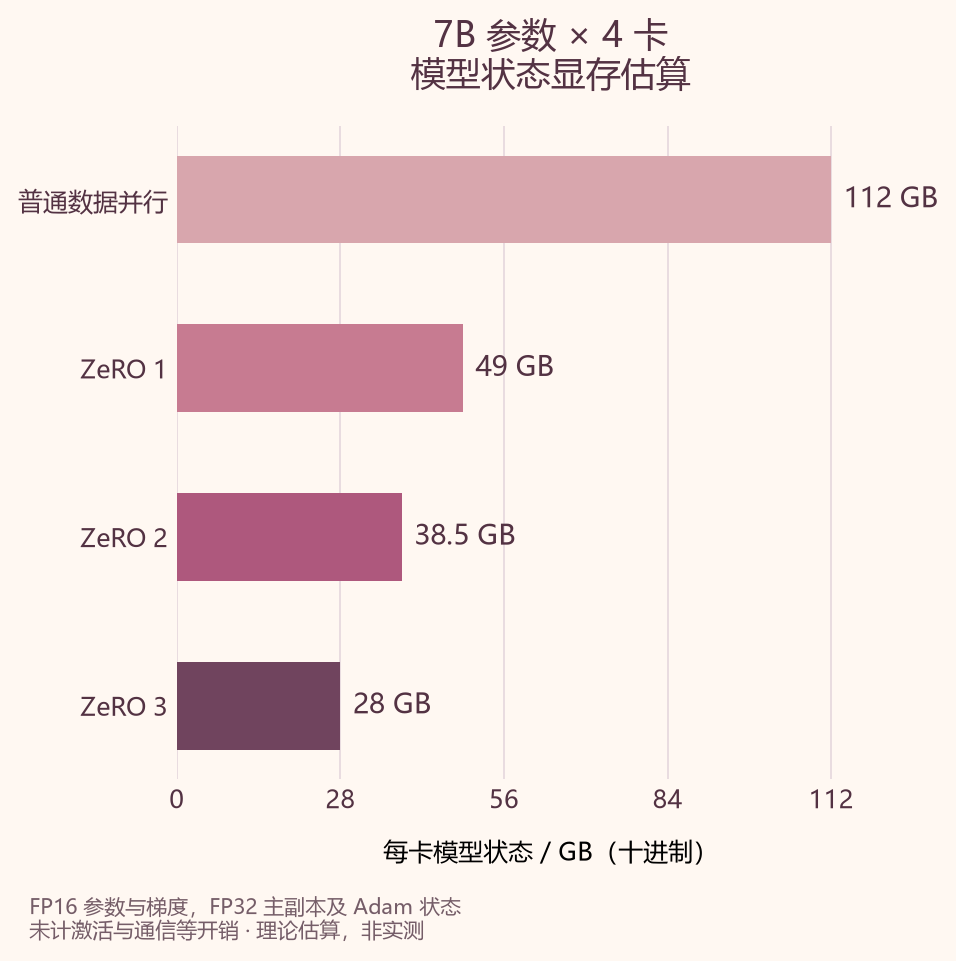
图由上述公式绘制,GB 为十进制单位,不是 GPU 实测。激活与通信等额外开销意味着 28 GB 的状态估算不能直接证明某张 32 GB 显卡能完成训练。实际能否运行还取决于序列长度、微批量和实现细节。
ZeRO 3 为什么未必最快
分片减少常驻状态,但计算前后还需要通信。卡间带宽、每次消息大小、计算与通信能否重叠,都会影响速度。显存允许时,应比较不同阶段的实际步耗时,而不是把阶段编号当成性能排名。DeepSpeed ZeRO 教程
还要分清三种方法:
| 方法 | 主要拆分什么 | 思考角度 |
|---|---|---|
| ZeRO | 数据并行组内保存的模型状态 | 减少重复保存 |
| 张量并行 | 层内的张量计算 | 多卡共同完成层内运算 |
| 流水线并行 | 模型的不同层 | 不同设备负责不同阶段 |
它们可以组合使用,但分工不同。先画清“每张卡保存什么、计算什么、交换什么”,比记缩写更容易理解。
Offload 和激活检查点各管什么
Offload 将部分状态移到 CPU 内存,特定方案还能使用 NVMe。它把一部分 GPU 容量压力转移到主机和传输路径上,是否合算要结合带宽与步耗时判断。ZeRO 3 Offload 说明
激活检查点则减少中间激活的保存,在反向传播时重新计算一部分前向。它处理的是前面状态账本之外的另一项成本。激活重计算论文
排查显存时,可以先看参数与优化器状态,再看序列长度、微批量和激活;确认瓶颈之后再选择分片、Offload 或重计算。
下一次实验应记录什么
固定模型、有效批量、精度和序列长度,对比 ZeRO 阶段,记录稳定后的每步时间、每卡峰值显存与是否发生 OOM。如果还改变了 Offload,就单独增加一组配置,避免无法解释差异。
完整训练检查点也不一定等同于可直接推理加载的完整权重。使用 ZeRO 3 时,保存、恢复和导出要按所用版本的流程处理。DeepSpeed 检查点文档
继续阅读:入门实验与 Agentic RL