前几篇笔记梳理了 KV Cache 和 ZeRO。接下来真正需要检查的是:在手边的机器上,哪些现象能测出来,哪些结论还缺少实验支持?
这次使用 RTX 3050 Laptop GPU 4GB,从小模型服务、张量容量和微型训练入手。网站服务器没有 GPU,实验在本机完成,博客只保存文章与结果。这里的推理结果属于固定的旧版 vLLM 环境,不作为当前 V1 引擎或大型 GPU 服务器的性能基准。
运行环境与复现材料
| 项目 | 实际设置 |
|---|---|
| GPU | NVIDIA GeForce RTX 3050 Laptop GPU,4GB |
| CPU | AMD Ryzen 7 5800H,16 个逻辑处理器 |
| 系统 | WSL2 Ubuntu 20.04,WSL 内存约 6.7 GiB |
| 驱动与运行时 | Windows 驱动 526.56,CUDA 11.8 |
| Python 与 PyTorch | 3.10.22,2.4.0+cu118 |
| 推理与训练框架 | vLLM 0.6.1.post1+cu118,DeepSpeed 0.15.2 |
| 注意力后端 | XFormers 0.0.27.post2+cu118 |
| 模型 | Qwen/Qwen2.5-0.5B-Instruct,FP16 |
| 模型 revision | 7ae557604adf67be50417f59c2c2f167def9a775 |
旧驱动限制了可直接使用的预编译环境,因此采用官方文档列出的 CUDA 11.8 构建路线。选择 0.5B 模型是为了适配 4GB 显存。vLLM 历史版本安装说明
复现与核对入口:
实验一 KV 张量到底占多少空间
先做一个容易核对的实验:只分配代表 K 和 V 的 FP16 张量,再读取 CUDA 张量分配增量。设 24 层、2 个 KV 头、每头 64 维,改变批量与缓存长度。这组形状与所用小模型的注意力配置对应。Qwen 模型配置
每组重复三次,共 36 次分配检查。WSL 主实验的 36 次结果均与字节公式一致:
$$ M=2\times24\times B\times2\times T\times64\times2 $$
| 缓存长度 | 批量 1 | 批量 4 | 批量 8 |
|---|---|---|---|
| 128 token | 1.5 MiB | 6 MiB | 12 MiB |
| 512 token | 6 MiB | 24 MiB | 48 MiB |
| 1024 token | 12 MiB | 48 MiB | 96 MiB |
| 2048 token | 24 MiB | 96 MiB | 192 MiB |
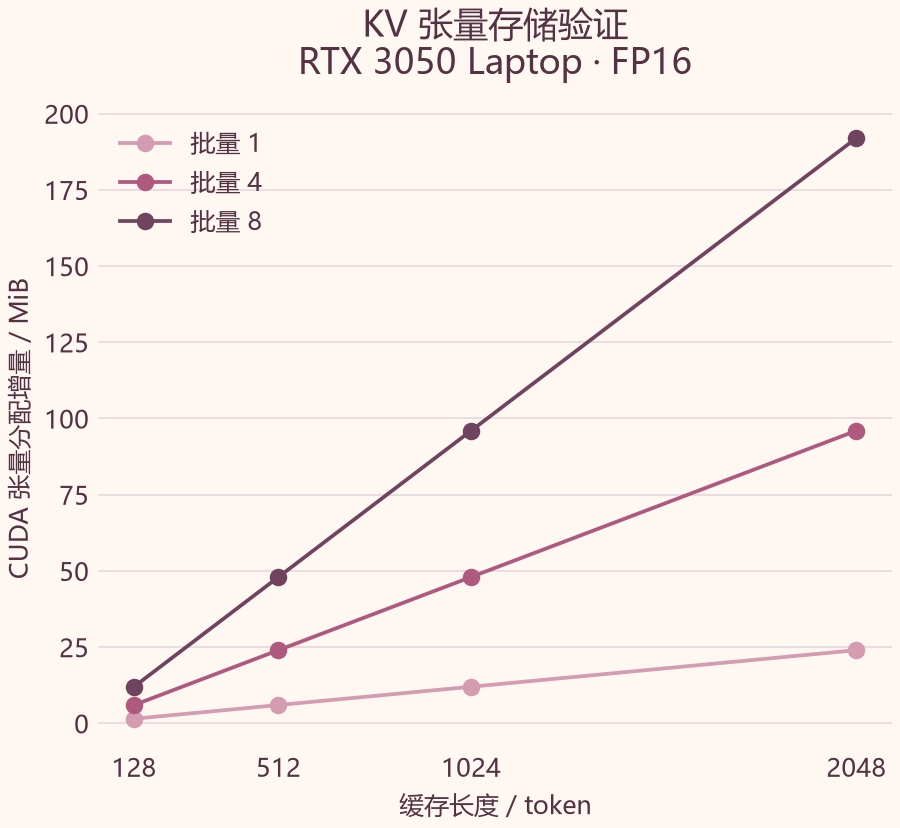
这验证了这组稠密张量的存储容量,没有执行注意力计算,也没有测量 vLLM 的显存峰值。张量使用 torch.empty 分配,因此结果不能用来讨论计算速度。
vLLM 会预先分配 KV 块池;请求改变时,池内的使用情况与整个进程占用不必同步变化。memory_allocated 统计张量占用,memory_reserved 统计 PyTorch 缓存分配器管理的空间,两者都不能直接当成 nvidia-smi 的进程占用。PyTorch CUDA 内存说明
原始数据还附带 Windows 下 PyTorch 2.7.1+cu118 的另外 36 次同形状复核,结果也一致;上表和图采用 WSL 主实验数据。
实验二 并发提高以后体验怎样变化
先固定服务:上下文上限 1024、最大序列数 8、每批 token 预算 1024、显存利用配置 0.8,关闭 CUDA Graph,启用 eager 模式;本组不开启前缀缓存。WSL 环境日志显示 pin_memory=False。这些都是本次结果的条件,未寻找全局最优配置。
客户端使用相同的公开合成文本,以 token ID 保证输入长度;每次强制生成 64 token,温度为 0,并忽略 EOS。这样控制的是负载大小,不评价回答质量。客户端采用固定数量工作线程,每完成一个请求再补下一个,属于封闭循环负载。
四组配置各运行三轮,每轮 16 个请求,共 192 个请求,全部成功,输出 12288 token,另有三次不计入统计的预热。十二轮测量顺序用固定种子打乱。
| 输入 token | 并发 | 输出 token/s | 客户端 TTFT ms | 客户端 TPOT ms |
|---|---|---|---|---|
| 128 | 1 | 31.7 | 74.0 | 30.6 |
| 128 | 4 | 80.7 | 248.0 | 46.5 |
| 128 | 8 | 147.0 | 465.0 | 48.5 |
| 512 | 4 | 64.8 | 688.4 | 51.2 |
吞吐取三轮结果的中位数;TTFT 与 TPOT 分别汇总每组 48 个请求后取中位数。TTFT 从发出请求计到收到第一段非空输出;TPOT 按首段输出之后到请求结束的时间除以剩余输出 token 数估算,包含客户端与传输开销,并非 GPU 内核耗时。
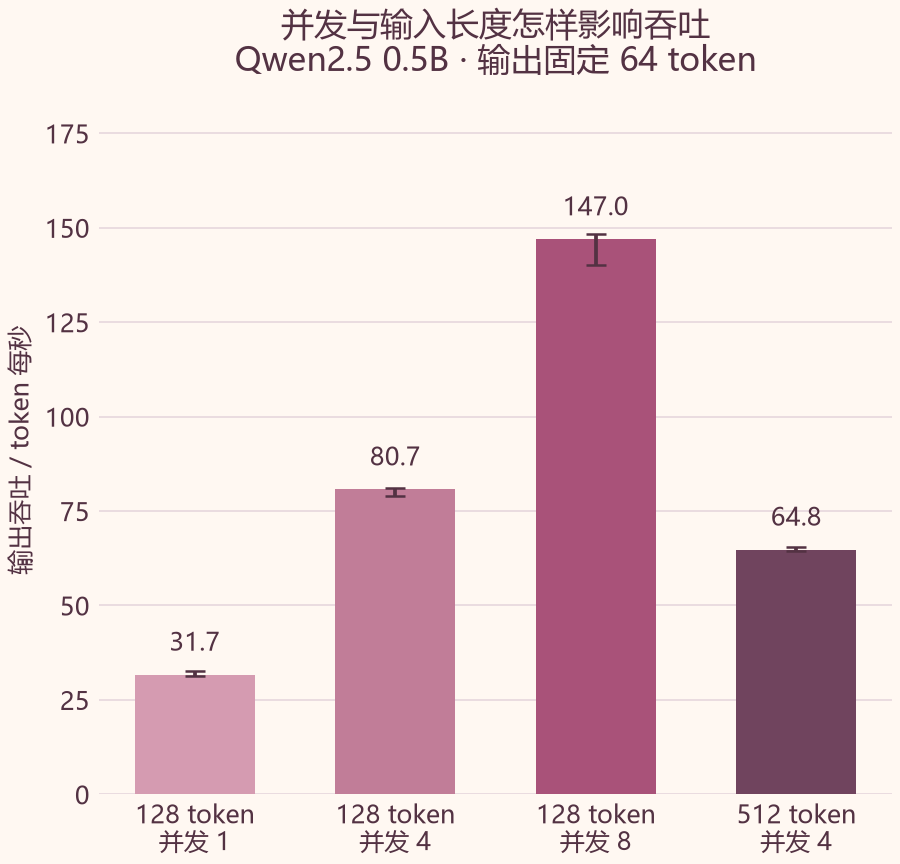
图中误差线表示三轮吞吐的最小到最大范围,不是置信区间。
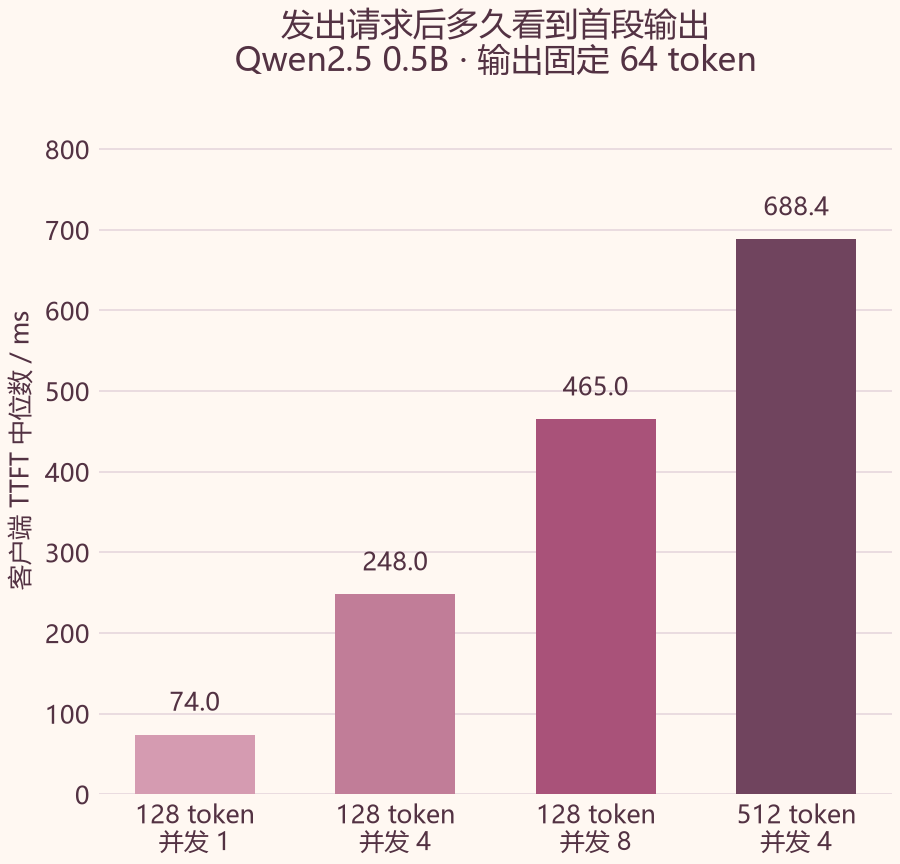
在相同的 128 token 输入下,并发 8 的整体吞吐约为并发 1 的 4.6 倍,但首段等待从 74 ms 增加到 465 ms。更多人一起使用时,服务整体处理得更多,并不表示每个人都等得更少。
并发固定为 4 时,512 token 输入的首段等待也高于 128 token。本实验测量的是客户端时间,不能把差值全部当作 GPU Prefill 的计算时间。笔记本未锁定功耗与时钟,结果也不应直接外推到专用服务器。
实验三 相同前缀能省掉什么
随后开启前缀缓存,保持 512 token 输入、并发 4、64 token 输出,先用同一个输入预热三次,再测三轮、每轮 16 个请求。新增的 48 个正式请求全部成功。
| 设置 | 输出 token/s | 首段等待中位数 | TPOT 中位数 |
|---|---|---|---|
| 关闭缓存 | 64.8 | 688.4 ms | 51.2 ms |
| 开启并预热 | 78.9 | 125.4 ms | 49.9 ms |
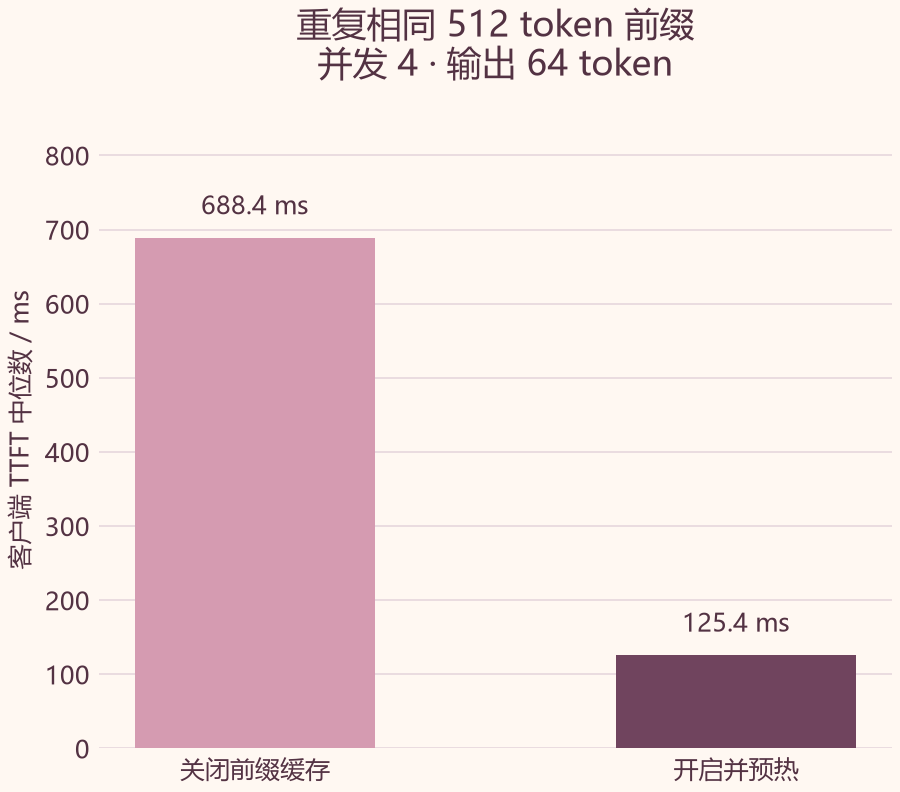
最后一次服务指标采样中,GPU 块缓存命中率约为 88.1%。这是框架的块级统计,不能解读成“88% 的请求完全不计算”。
首段等待缩短,而 TPOT 仍接近原来的水平,符合前缀缓存减少重复输入处理、后续生成仍需执行的工作方式。这里所有测量请求使用完全相同的合成输入,是偏理想的复用场景;真实问答中的前缀不一定相同。
缓存开关分别在两个服务进程中顺序测量。开启组还补齐了即时编译工具链,没有随机交叉两种服务配置。因此这里用于演示功能与观察趋势,不将这个比值作为严格隔离的因果基准。
实验四 训练引擎与梯度累积是否正确
训练使用一个 128 → 256 → 4 的 MLP,共 34052 个参数,FP32,优化器为 PyTorch AdamW,学习率 0.003。512 个输入样本固定生成,标签由一个固定的随机线性教师给出;模型种子为 42,数据种子为 123。
这样可以检查模型是否确实在学习这组数据。它与每一步重新抽取随机标签的流程演示不同,但仍然是微型合成任务,不能当成语言模型训练或独立测试集评测。
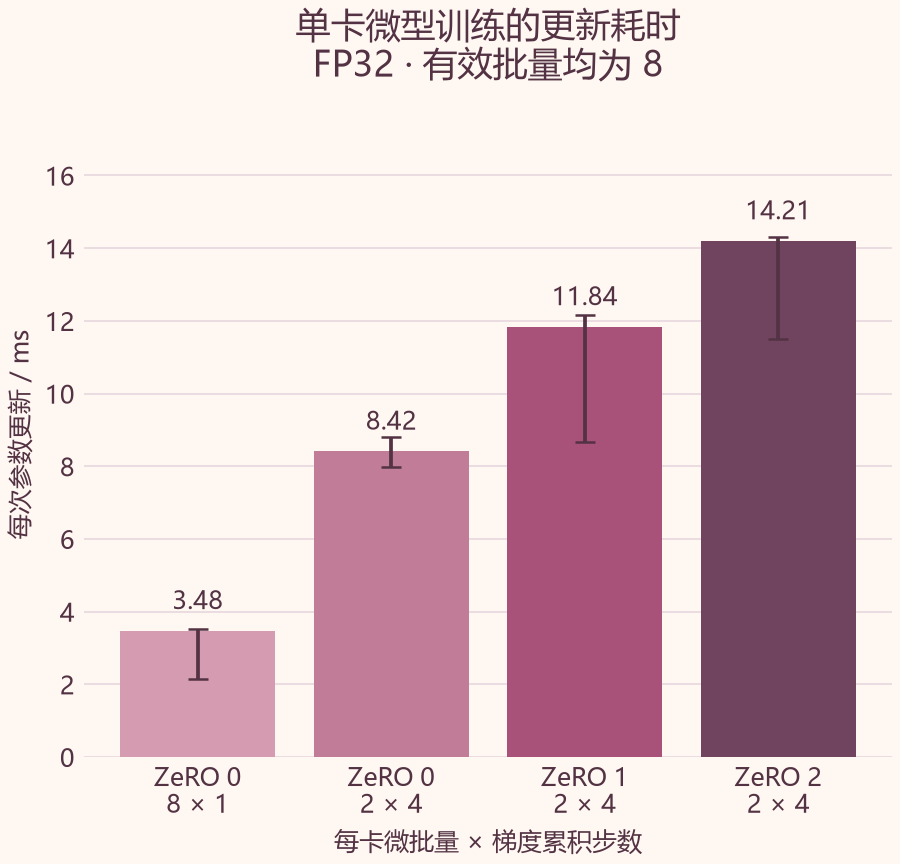
四种配置各重复三次,每次完成 80 次参数更新,共 960 次。所有配置有效批量均为 8;在单卡上满足:
$$ B_{effective}=B_{micro}\times G_{accumulation}\times1 $$
| 配置 | 微批量 × 累积 | 更新耗时中位数 | 最终损失 |
|---|---|---|---|
| ZeRO 0 | 8 × 1 | 3.48 ms | 0.278746 |
| ZeRO 0 | 2 × 4 | 8.42 ms | 0.278746 |
| ZeRO 1 | 2 × 4 | 11.84 ms | 0.278746 |
| ZeRO 2 | 2 × 4 | 14.21 ms | 0.278746 |
耗时以一次真正的参数更新为单位,包含该更新所需的全部微步;每次更新前后同步 CUDA,排除前十次更新,再取剩余七十次的中位数,最后汇总三轮。初始化和模型加载不计入更新时间。图中误差线是三轮结果的最小到最大范围。
所有运行在固定训练集上的整体损失均从 1.415415 降到约 0.278746,训练集准确率为 96.68%。这里没有独立测试集,准确率只用于确认这个固定任务上的拟合,不能作为泛化能力。
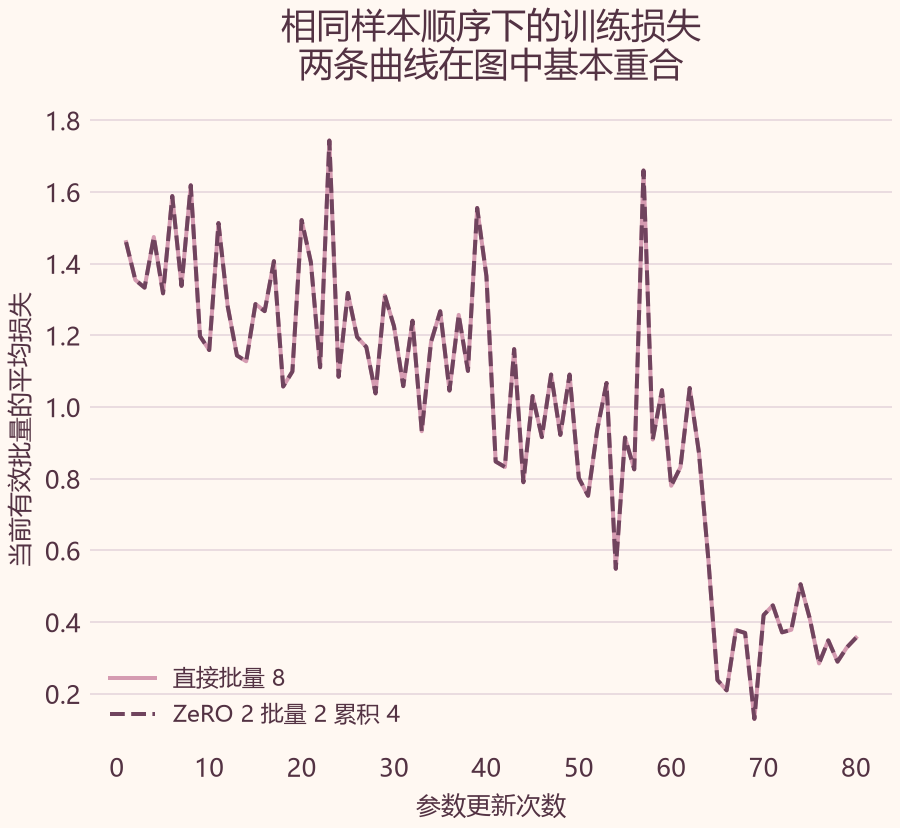
曲线按每次有效批量的平均损失绘制。不同更新使用的样本不同,因此会有波动;整体前后损失则在同一组 512 个样本上计算。
更直接的检查是比较最终参数。以 ZeRO 0,微批量 8,累积 1 为参考,其余三种配置、三个重复的最大绝对参数差异均约为 $5.22\times10^{-8}$,通过事先设置的 $10^{-4}$ 检查阈值。说明在本例的模型、损失平均方式和样本顺序下,梯度累积实现了数值上非常接近的更新。
这不意味着所有训练设置都自动等价。真实语言模型还要处理不同样本的有效 token 数、损失归一化与随机层;先核对这些条件,再使用梯度累积。
本次单卡微型任务中,拆成更多微步和引入 ZeRO 管理都有开销。单卡没有跨卡分片收益,也不能用这个小模型的耗时给 ZeRO 阶段排名。
原始文件还记录了 PyTorch 张量分配峰值和缓存保留峰值。各次运行的张量分配峰值约为 66.3 至 72.3 MiB,包含数据、库工作区等开销。矩阵在一个进程中重复初始化引擎,缓存可能跨组存活,因此这些峰值只作为本次进程观测记录,不将几 MiB 的差值解释为 ZeRO 的显存收益。
过程中遇到的兼容问题
| 现象 | 定位与处理 | 是否计入正式数据 |
|---|---|---|
| 第一次请求返回 HTTP 500 | 默认结构化输出依赖缺少 pyairports 模块;显式选择内置 lm-format-enforcer 后端 |
否,仅保留失败日志 |
DeepSpeed 安装报 CUDA_HOME 缺失 |
下载并校验 NVIDIA CUDA 11.8 开发包,设置实际工具链路径 | 不属于性能测量 |
| 缓存命中后的请求失败 | Triton 的前缀处理路径需要 C 编译器;安装 GCC/G++,使用 CUDA 11.8 的 ptxas 后复测成功 |
失败预检单独保留 |
这些现象说明,服务启动成功还不足以证明所有执行路径可用。普通生成、缓存命中和训练初始化都应分别做短预检。这里没有修改 vLLM 或 DeepSpeed 的内核代码。
怎样复现和继续扩展
ZIP 内包含计划、脚本、软件包版本、模型文件校验信息、逐请求测量、训练轨迹、最终参数检查点、汇总表和经过路径处理的日志。先阅读其中的 README.md,准备独立环境,再执行脚本。
本轮完成的是 72 次张量存储检查(两个环境各 36 次)、240 个正式推理请求、12 组微型训练与 9 次最终参数对照。预热与失败预检不计入正式推理请求。
下一步需要不同资源的实验仍明确保留:双卡 ZeRO 分片、真实语言模型训练、当前 vLLM V1 版本对照,以及 Agentic RL 的轨迹生成与策略更新。本机只有一张 GPU,本轮没有运行这些实验,也没有创建付费算力实例。
后续每次更新沿用同一流程:明确问题与对照条件,先短预检,再重复测量,保留原始文件,最后把图表、结论与适用范围一起写回博客。